一.背景
随着智能体在查资料、写方案、代码生成、总结分析以及 Vibe Coding 等复杂任务中的广泛应用,Token 消耗正在成为平台侧持续增长的核心成本压力来源。在实际运行过程中,单次复杂任务往往需要消耗数千到上万 Tokens,而在真实业务场景中,大量用户问题本质上是重复或高度相似的,但系统仍需每次重新调用大模型进行完整推理。这种“重复问题 + 重复推理”的模式,导致大量算力被无意义消耗,平台整体推理成本持续上升,逐渐成为规模化落地的重要瓶颈。
与此同时,用户侧在高频使用智能体过程中也面临明显的体验与成本压力。相同或相似的问题需要反复提交并等待模型重新生成结果,每一次调用都伴随新的费用消耗。随着使用频率提升,这种重复调用带来的成本累积效应越来越明显,不仅增加了用户负担,也降低了交互效率与体验连续性。在部分场景下,甚至出现同一问题多次付费、多次等待的情况,进一步放大了使用痛点。
二.现存核心痛点
成本高昂:复杂业务任务单次调用消耗数千至上万 Token,长期累积成本压力大;
资源浪费:同质化、重复性问题重复请求大模型,产生无效算力与 Token 消耗;
响应缓慢:所有请求统一走大模型生成链路,依赖云端推理交互延迟高
无法沉淀价值:历史优质回答无法复用,每次需求均从零开始生成。
三. 整体解决方案
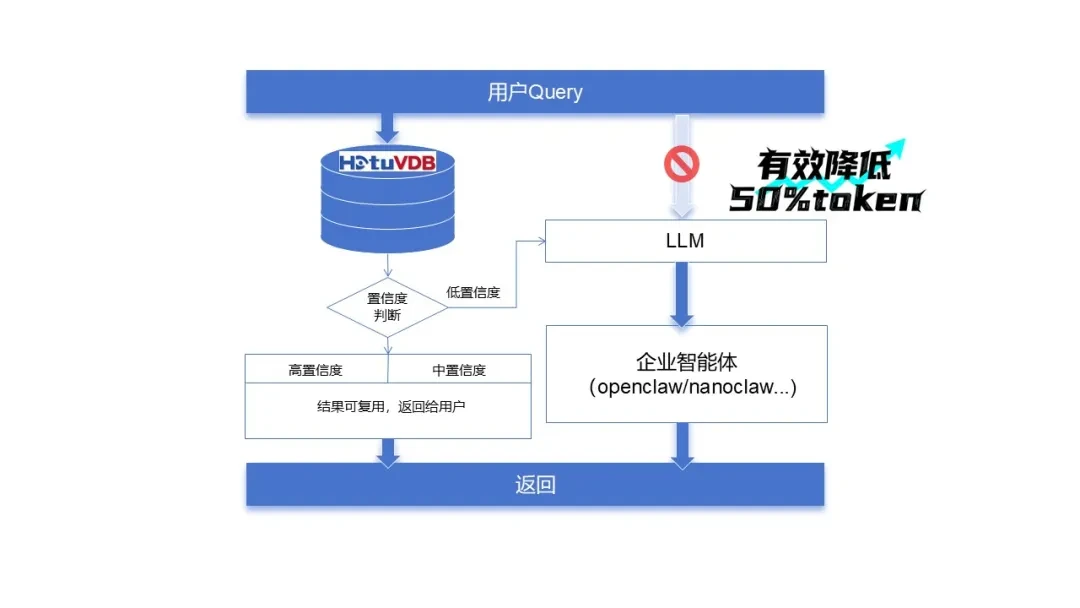
在业务智能体与大模型 LLM之间,新增 HetuVDB 向量缓存中间层,构建智能体长效记忆能力。
核心逻辑:优先检索历史沉淀数据,按需分级调用大模型,实现重复需求的零消耗、相似需求降消耗、全新需求自动向量化持久存储,如图所示。
相同语义问题:直接调取历史优质答案,零 Token 消耗;
相似业务需求:复用历史上下文内容,降低 50% 以上推理 Token;
全新未知问题:正常调用大模型处理,优质结果自动向量化持久存储,支撑后续降本。
针对全新未知问题的持久存储需求,入库核心内容包含携带上下文信息的改写后 Query 向量、原始 Query 文本、用户认可的优质答案及任务类型标签;通过该机制可有效避免无效答案占用缓存资源,以用户实际认可为标准保障内容复用质量,同时实现体系持续迭代优化,问答资源不断积累丰富,长效提升整体降本效果。
四.核心机制(多级置信度分级策略)
依托语义相似度计算,对用户提问进行分级判定,差异化制定调用策略,平衡降本与输出质量。
语义置信度 | 执行策略 | Token消耗占比 | 场景说明 |
≥ 90% | 结果直接复用 | 0% | 高度重复需求,历史答案完全适配,无需大模型 |
75% ~ 90% | 结果复用 + 辅助确认 | <5% | 需求高度相似,存量答案可直接参考使用 |
60% ~ 75% | 历史内容注入上下文 | 30%-50% | 存在部分共性逻辑,依托参考内容减少推理成本 |
< 60% | 全流程调用大模型 | 100% | 全新业务需求,无历史参考,正常生成并沉淀 |
高置信度(≥90%):不用调 LLM,直接返回。Token 消耗→0,但需要确保答案真的能用
中置信度(75-90%):让用户确认,节省的不是推理 Token 而是等待时间
中低置信度(60-75%):把缓存内容当参考喂给 LLM,LLM 少想少推理,消耗降 30-50%
低置信度(<60%):真没见过,走完整流程。但用户认可后,这个答案就 "活" 了
五.Token 节省效果测算
结合实际业务任务结构分布,全场景实现规模化 Token 降本。
任务类型 | 占比 | 主要策略 | Token 节省 |
重复任务 | 30% | 直接命中 | 95% |
相似任务 | 35% | Context 复用 | 40-60% |
全新任务 | 35% | 正常执行 + 落库 | 0% |
综合整体收益:实现约50% Token消耗节省。
方案建立完善的质量保障体系,缓存复用内容均为用户认可的优质问答,确保输出结果稳定可靠;针对相似问题依托历史内容辅助生成,有效规避大模型无依据创作问题,同时完整保留大模型原生能力,可正常承接各类全新复杂业务需求,全面保障业务稳定运行与内容输出质量。
六、方案总结
本方案基于 HetuVDB 缓存层,在智能体与大模型之间引入“记忆与复用机制”,用于对重复与相似问题进行高效识别与复用,从而显著降低整体 Token 消耗。在该机制下,系统可实现综合节省 50%+ Token 消耗,在缓存命中场景中响应延迟降低 90%+,同时显著改善用户体验,使重复问题能够秒级返回,无需重复等待与重复计费。更重要的是,通过将用户认可的高质量结果自动沉淀为可复用的知识资产,系统能够持续积累有效问答能力,随着使用频率提升不断提高命中率与复用效率,实现长期成本持续下降与整体系统能力持续增强,本质上是用“记忆与复用能力”替代“重复计算成本”,推动智能体从一次性调用系统向可持续进化的知识系统演进。